技能之锤
AI Agent 的 Evals 到底怎么做?
 虎头锤 · Staff Engineer
周末朋友推荐了 Anthropic Engineering 的一篇文章:Demystifying evals for AI agents。
文章很长,回答的是对我们来讲越来越现实的一个问题:
我们怎么知道一个 AI Agent 真的变好了?
如果是古法编程,这事儿我们就很熟悉。一个函数输入 2 和 3,应该返回 5。一个 API 收到非法参数,应该返回 400。代码改完,跑 unit test、integration test,至少能知道有没有把原来正确的东西搞坏。
但 AI Agent 跨越了简单的 Input → Output,变成了:
Task → 多轮交互 → 调工具 → 观察结果 → 调整策略 → 改变环境 → 得到最终结果
同一个任务跑两次,还可能走两条完全不同的路。
所以除了结果对不对,还要看:
AI Agent 完成了什么?过程是怎样的?再做一次还能不能完成?
这就是 Evaluation,也就是 Eval 要解决的问题。
不想读文章可以先看看这张图:
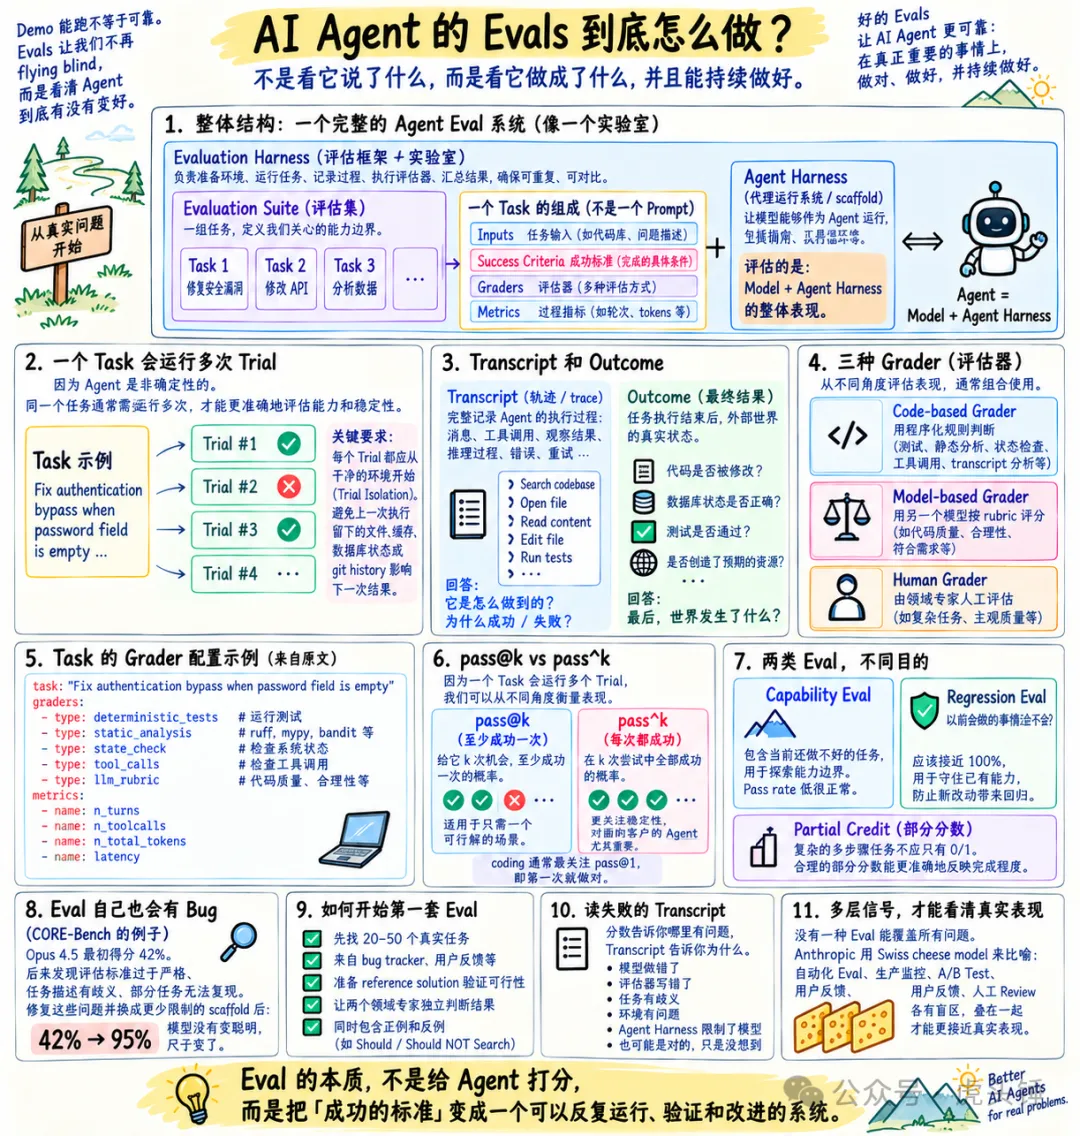
01. Demo 能跑,不等于 Agent 可靠
很多 AI 产品最初都是这么开发的。
写一个 prompt,跑一下。不错。换几个例子再跑,好像也没问题。于是继续往前做。
早期这么做很正常。manual testing、dogfooding 加上工程师自己的判断,可以推进相当长一段时间。问题往往出现在产品上线、用户增加、系统越来越复杂以后。
用户开始说:
怎么感觉这个版本反而变笨了?
团队改 prompt。A 问题好了,B 问题坏了。换一个更强的模型,某些任务提升了,另外一些行为又发生变化。再加一个工具,Agent 能做更多事情,却开始在某些任务上莫名其妙绕很多步。
麻烦在于:没有办法回答"它到底有没有变好"。
只能:
发现问题 → 人工复现 → 修改 → 手测 → 上线 → 等下一次用户投诉。
Anthropic 把这种状态形容为 flying blind,没有仪表盘的瞎飞。
Eval 就是给这个系统装仪表盘。
02. Agent Eval 更像一个实验室
原文有一张很重要的图,里面放了一组概念:
Evaluation Harness、Evaluation Suite、Task、Trial、Transcript、Outcome、Grader、Agent Harness。
我稍微解释一下,画成一张结构图大致是这样:
Evaluation Harness 是运行整套 Eval 的基础设施。
里面有一个 Evaluation Suite,也就是一组 Task。
每个 Task 可以运行一次或者多次,每运行一次叫一个 Trial。
Trial 会留下两类重要信息:
- Transcript:Agent 的执行过程。
- Outcome:执行结束后环境的最终状态。
Grader 根据这些信息评分。
还有一个容易混淆的概念:Agent Harness,也叫 scaffold。它负责让模型作为 Agent 工作,包括 instructions、tools、tool calls 和 agent loop。
因此实际被评估的是:
Agent = Model + Agent Harness
同一个模型换一套 Agent Harness,最后的表现可能完全不同。
把这些东西放在一起,Agent Eval 很像一组可重复运行的实验:控制环境,给出任务,让 Agent 执行,留下过程和结果,再判断是否达到预先定义的成功标准。
03. Task 不是一个 Prompt
原文给了一个 Coding Agent 修 bug 的 Task:
Fix authentication bypass when password field is empty ...
只有这句话,还没法做 Eval。
首先得回答:
怎样才算把这个 bug 修好了?
原文示例里用了几种 Grader:
- deterministic_tests:跑确定性的测试。
- static_analysis:运行 ruff、mypy、bandit。
- state_check:检查最终系统状态。
- tool_calls:检查工具调用。
- llm_rubric:让模型按照 rubric 评价代码。同时还可以记录 n_turns、n_toolcalls、n_total_tokens、latency 等 Metrics。
例子中的 YAML 是为了展示不同类型的 Grader,所以配置得比较全。实际 coding eval 通常主要依靠 unit tests + LLM rubric,其他按需添加。
一个 Task 大致可以写成:
Inputs + Success Criteria + Graders + Metrics
实际操作中 Grader 和 Metric 也没有绝对边界。比如 n_turns 可以只是观察指标。如果产品明确要求"10 turns 内必须完成",max_turns: 10 就成了成功条件,可以直接进入 Grader。
最终还是回到 Success Criteria:什么情况算这个 Task 完成了。
04. 同一道题,为什么要跑很多次?
传统测试里,一个 test case 跑一次通常就够了。
Agent 不行。
Task A
 ├─ Trial #1 → Pass
 ├─ Trial #2 → Fail
 ├─ Trial #3 → Pass
 └─ Trial #4 → Pass
同一个模型、同一个任务、同一个环境,两次执行仍然可能使用不同工具、走不同路径、做出不同决定。一次成功,只能说明这一次做到了。多个 Trial 才能看出成功是否稳定。
这里还涉及 Trial Isolation。
每个 Trial 都应该从干净环境开始。Anthropic 遇到过 Claude 查看前一个 Trial 留下的 git history,从中获得额外信息的情况。共享文件、缓存、数据库状态、git history,甚至资源竞争,都可能污染下一次 Trial。实验环境不独立,最后的数字也很难解释。
05. Transcript 和 Outcome
每个 Trial 都会留下 Transcript。原文也使用 trace、trajectory 这些叫法。
一次 Coding Agent 的执行可能是:
Read README
  ↓
Search "authenticate"
  ↓
Open AuthService.ts
  ↓
Modify middleware
  ↓
Run tests
  ↓
3 tests failed
  ↓
Inspect error
  ↓
Modify implementation
  ↓
Run tests again
  ↓
Pass
这是执行过程。
Outcome 看的是最后的环境状态。Agent 说:
I've fixed the authentication vulnerability.
用久了 AI 的小伙伴都知道,这句话啥都证明不了。真正的 Outcome 包括代码有没有改变?漏洞是否消失?tests 是否通过等等。
原文有一条我很喜欢的原则。
Grade the outcome, not the path.
从我的角度看,这和以前做 BDD 的思路很像:先定义期待发生什么,而不是把实现路径写死。
Eval 很容易被写出一种白盒测试的感觉:
必须先调用 A
然后调用 B
参数必须是 X
最后调用 C
结果就会导致 Agent 换一条合理路径,即使结果正确,也会被判 Fail,这种测试会变得非常脆弱。除非某个步骤本身就是 requirement,否则应该优先检查最终 Outcome。
Transcript 仍然很重要。失败时,它能解释问题出在哪里;如果某些过程本身属于安全或业务要求,也可以直接进入 Grader。
简单来讲就是:Outcome 判断结果是否成功,Transcript 帮助定位为什么。
06. Grader 怎么设计
Anthropic 把常见的 Grader 分成三类:Code-based、Model-based、Human。
Code-based 最直接。Tests、regex、static analysis、state check、tool-call verification 都属于这一类。确定性能判断的东西,直接用代码判断通常更合适。速度快、成本低、结果稳定,容易 debug。
Model-based Grader 适合代码质量、回答质量、研究报告完整度这类很难写成 assertion 的东西。Judge 自己也是概率模型,需要和人工判断持续校准。原文给了几个实用建议:允许 Judge 返回 Unknown;不同维度可以使用独立的 Judge;rubric 要清晰、结构化。
Human Grader 肯定是又贵又慢,但在高价值任务以及校准 LLM Judge 时仍然有价值。
复杂任务还需要考虑 Partial Credit。
举例来讲,客服 Agent 正确理解问题、完成身份验证、找到订单,最后退款失败,和第一步就理解错问题显然不是同一种失败。全部记成 0,会丢掉大量信息。
Grader 本身也可能有漏洞。因为 Agent 可能没有解决问题,却找到一种办法让测试通过。设计 Grader 时需要检查这一点:通过测试的可靠方式,应该是完成任务本身。
07. Capability 和 Regression
Anthropic 把 Eval 分成两个重要方向。
Capability Eval 用来寻找 Agent 当前的能力边界。里面应该包含它暂时还做不好的任务,所以 Pass rate 低很正常。
Regression Eval 用来守住已经获得的能力。以前能完成的任务,升级以后应该继续完成,通过率通常应该接近 100%。
两者之间还有一个自然的转换过程:
Capability Eval → 能力提高 → Eval 接近饱和 → Regression Suite
这其实就跟传统软件工程的流程 match 上了:bug → fix → regression test
08. 会做,和靠谱,是两回事
当同一个 Task 运行多个 Trial 后,就可以开始衡量稳定性。
文章介绍了两个指标。
- pass@k:k 次尝试里至少成功一次。
- pass^k:k 次全部成功。
Coding Agent 通常很关心 pass@1。毕竟真正工作时,第一次能不能做对很重要。
而面向客户的 Agent 则尤其需要关注 pass^k。
假设单次成功率是 75%,三个 Trial 全部成功的概率只有 0.75³ ≈ 42%。单看 75% 好像还可以,换成"用三次都不能出问题",42% 就没那么让人放心了。
所以能完成一次任务,和能稳定完成任务,是两个指标。
09. 第一套 Eval 不需要几百个任务
原文给了一个很实际的工程建议:先找 20–50 个真实任务。
bug tracker、support queue、用户反馈、release checklist,都可以直接提供素材。真实 failure 尤其有价值。问题修掉以后,把它留下来做 Regression Eval。
当然 Task 本身也要检查。一个很好的标准是:两个 domain expert 独立看同一个 Task,应该能得出相近的 pass/fail 判断。
如果任务要求 Agent 写一个 script,却没有规定保存路径。测试程序自己假定文件必须放在某个目录。Agent 把 script 写对了,只是放在另一个合理的位置,于是 Fail。这种时候,出问题的是 Eval。
Reference Solution 可以提前验证两件事:Task 确实能完成,Grader 也能正确判断。
正例和反例同样需要。比如 Anthropic 在 Web Search Eval 中会同时测试:Should Search 和 Should NOT Search。如果忽视了反例,那么很容易优化出一个什么都 Search 的 Agent。
10. Eval 自己也会有 Bug
原文里有个很有冲击力的例子。
CORE-Bench 上,Opus 4.5 最初的成绩是:42%。
后来研究人员检查 Eval,发现了不少问题。比如期望答案是 96.124991...,模型回答 96.12 也会被判错。还有 Task specification 的歧义,以及某些 stochastic task 无法精确复现。修复这些 Eval 问题,再换成限制更少的 scaffold 后,成绩从 42% 大幅上涨到 95%。
模型没有突然变聪明。
尺子变了。
因此,两个模型相差几分,未必能直接解释成能力差距。Task 测了什么、Grader 怎么写、有没有歧义、Agent Harness 有什么限制,都可能改变最后的数字。
Benchmark 的数字很精确,测量方法未必同样精确。
11. Eval 也会过时
Capability Eval 接近 100%,就会开始测不出新的东西了。
这就是 Eval Saturation。
比如原文提到的 Qodo 一开始没有从原来的 one-shot coding eval 中看到 Opus 4.5 很大的提升。后来他们重新开发 agentic eval framework,才更清楚地看到模型在更长、更复杂任务上的能力变化。
一套长期不变的 Eval,最后可能已经分辨不出模型新的能力提升。
Agent 在进步,Eval 也需要更新。
12. Read the transcripts
自动 Eval 做起来以后,很容易盯着 Dashboard:
Success rate 87%。Average turns 14.3。Token usage 38k。
Anthropic 特别强调:
Read the transcripts.
同一个 Fail,背后的原因可能完全不同。Agent 做错了,Grader 写错了,Task 有歧义,环境坏了,Agent Harness 限制了模型,都可能表现为同一个红色的 Fail。
还有一种情况:Agent 找到了一条合理的解决路径,只是写 Eval 的人没想到。
Score 适合定位问题。
Transcript 负责解释问题。
所以工程师现在除了读 logs、stack traces 之外,又多了一种东西要读。
13. Eval 只是其中一层
文章最后用了安全工程里的 Swiss cheese model。
Automated Eval、Production Monitoring、A/B Testing、User Feedback、Manual Transcript Review、Human Evaluation 都有各自的盲区。
多层信号叠在一起,才能更完整地观察 Agent 在真实世界里的表现。Eval Suite 做得再完整,也替代不了线上反馈。
毕竟真正重要的问题最终都会落到真实环境:
- 任务完成了吗?
- 用户的问题解决了吗?
- 系统状态正确吗?
- 新的 failure 出现了吗?
而这些信号还会继续产生新的 Eval。
14. 成功的标准
写到最后,问题又回到了最开始:
怎样才算一次成功的任务执行?
- 什么结果算成功?
- 什么错误不能接受?
- 哪些步骤必须遵守?
- 多少成本可以接受?
- 做到什么程度才算可靠?
Eval 把这些标准写下来:
Task → Constraints → Success Criteria → Graders → Outcome
一句"这个结果看起来不错",开始变成明确的任务、条件和判断方法。
模型会继续变强,Agent 能做的事情也会越来越多。
但评估最终还是落在两个问题上:
什么算成功?它能不能一次又一次地做到?
Eval 的本质,是把「成功的标准」变成一个可以反复运行、验证和改进的系统。