章节 20
有效性错觉
读进去
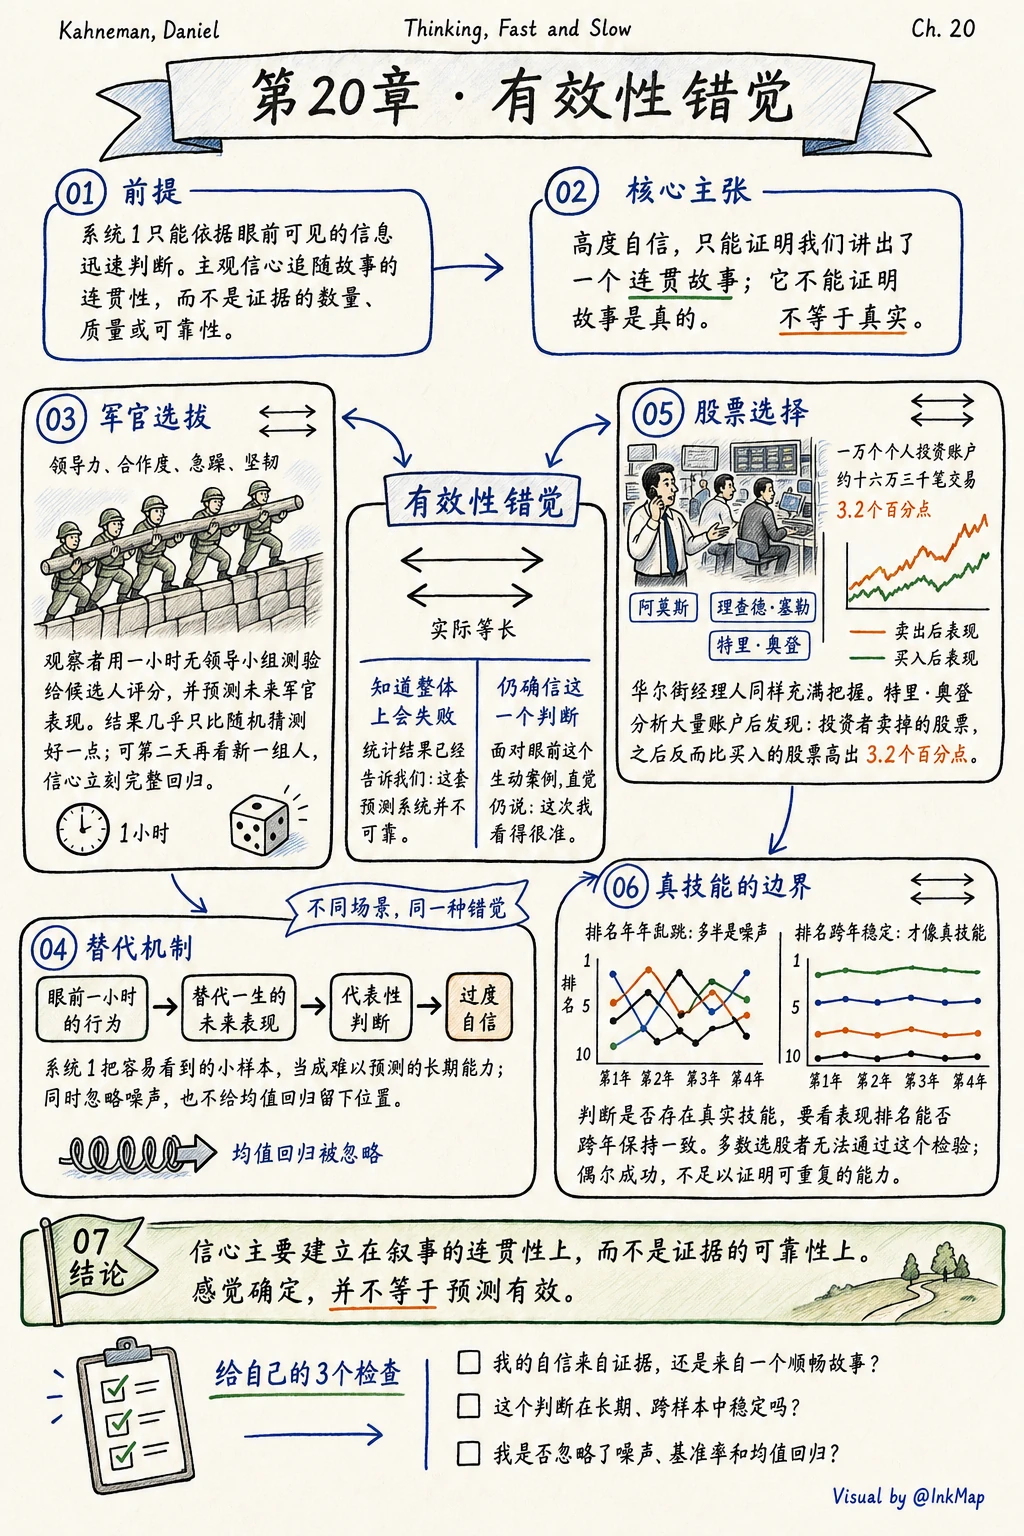
卡尼曼在军队里反复看到同一个现象:评估军官候选人的方法整体上不比随机猜更准,但每个评估者对自己下一次判断的信心丝毫不减。这不是固执,而是一种更深层的错觉——信心来自大脑把有限信息拼成一个连贯故事的流畅程度,而不是来自证据的充分性。整体失效的统计认知,无法自动转化为对具体个案的谨慎。
 打开原图 ↗
画出来
文字里常被当作一回事的是两个层级:对方法的整体评估,和对个案的即时判断。前者是统计问题,后者是感受问题。经过视觉化整理,这两层被分开:上层是“这套方法长期准确率接近随机”,下层是“我对眼前这个人的判断非常确定”。中间没有自动传导的通道。这个结构解释了为什么明知无效,人们依然自信——因为个案判断的流畅感,和整体准确率根本不在同一个认知层上。
再想一遍
面试流程里,一个面试官可能对某位候选人的技术判断非常笃定,但整个面试流程的预测效度可能很低。如果团队只讨论“这个面试官感觉准不准”,而不去检验“这套流程整体上能不能稳定区分好与差”,就会陷入有效性错觉。更常见的是,每次招聘失误后,大家会调整具体问题,却很少去验证调整后的流程是否真的提高了预测准确率。
带回生活
判断一个领域里有没有真实技能,唯一可靠的标准是个体表现能否长期稳定重复。一次判断听起来多笃定,都不构成证据。