章节 10
小数定律
读进去
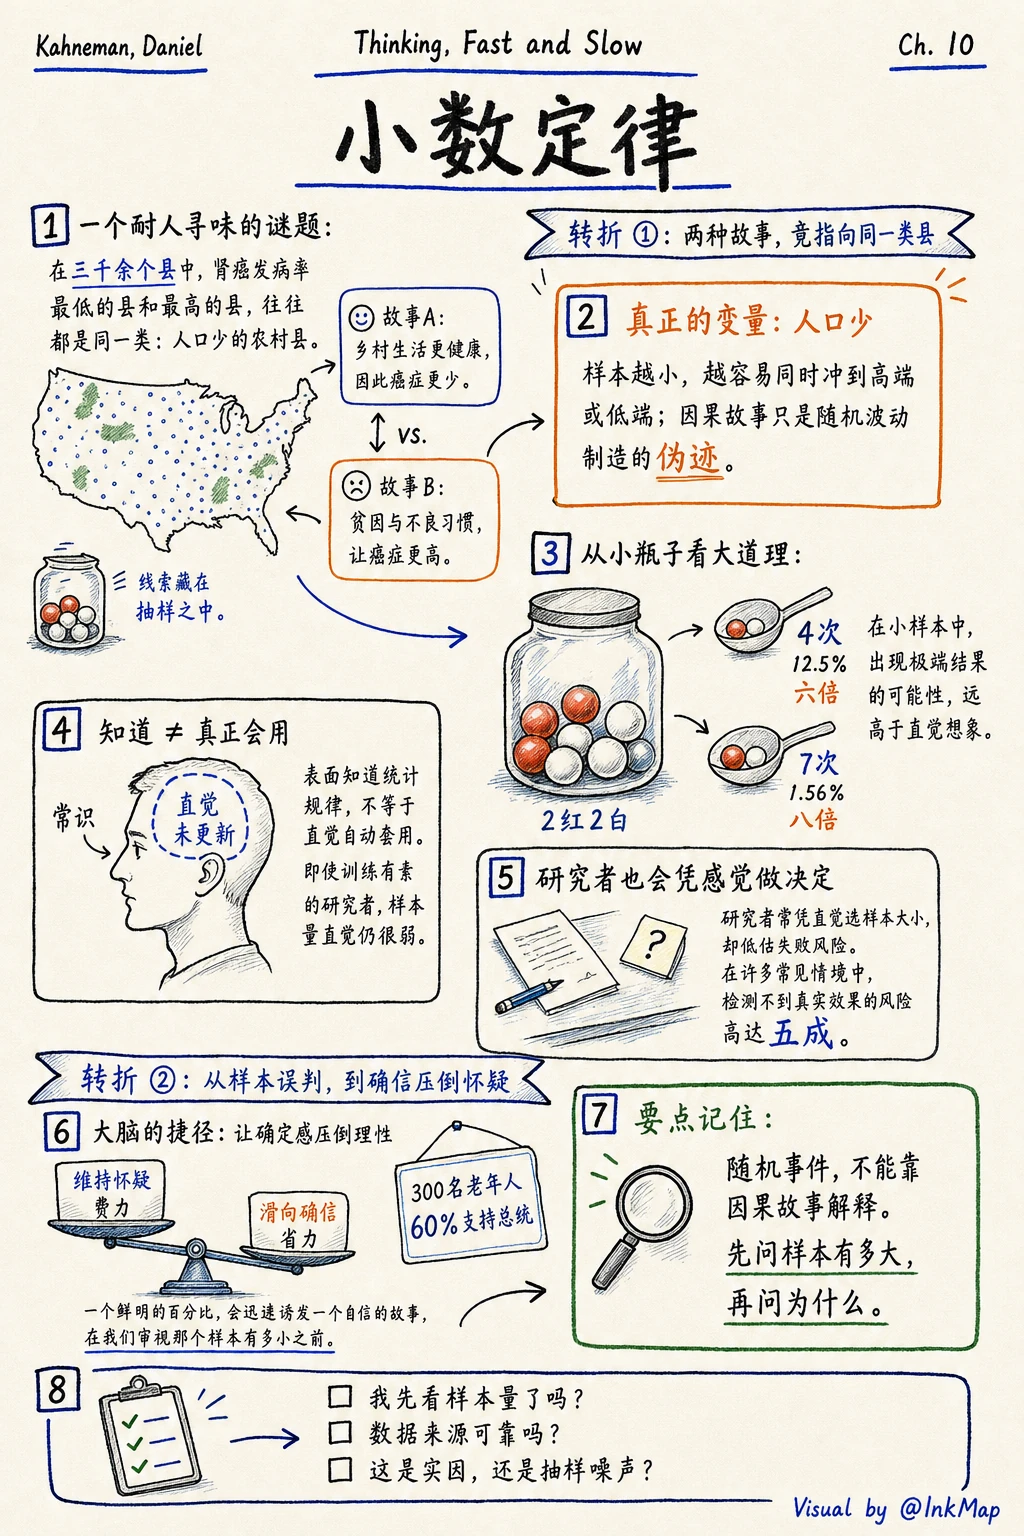
“小数定律”这个名字本身就容易让人误会。它不是一条关于小样本的规律,而是人脑强加给小样本的一条伪规律:我们默认小样本也能代表总体,于是把抽样波动当成了真实差异。
肾癌发病率最低的县往往是人口最少的县,这不是因为那里有什么保护因素,而是因为样本量小,极端值更容易出现。人脑不喜欢“这只是噪声”,它想要一个故事。于是我们开始编:是饮食习惯好,是空气干净,是生活节奏慢。故事越连贯,我们越不愿意回头问一句:样本有多大?
 打开原图 ↗
画出来
这一章的核心是一组对照:统计规律说小样本产生极端值,人类直觉说极端值背后必有原因。两者不是同一层面的解释,一个属于数学,一个属于叙事。把关系放进图里后,因果故事和抽样伪迹被放在两条不同的路径上,读者可以清楚地看到,同一个观察结果可能来自完全不同的生成机制。
再想一遍
A/B 测试里最常见的一种误判,就是把小流量下的显著差异直接当成产品改进的证据。一个按钮颜色让转化率提升了 20%,听起来很厉害,但如果实验组只有几百个用户,这个数字可能只是噪声。真正需要追问的不是“为什么提升了”,而是“这个样本量下,20% 的波动有多常见”。
带回生活
在看到任何统计结论之前,先问样本量。如果答案小于你的直觉预期,就把因果解释暂时挂起,直到有更大的样本把它接住。